Контент-завод: техническая сборка. Данные, API и контроль публикации

Эта статья — практическое продолжение материала «Контент-завод для АПК: как наладить выпуск экспертных материалов». Там разобран процесс: от досье компании до экспертной приёмки. Здесь — его техническая реализация: как хранить факты, подключать сервисы, проверять черновики и безопасно передавать их в CMS.
Главная инженерная цель — не «написать статью автоматически». Система должна выпускать проверяемые черновики, сохранять происхождение фактов и не давать опубликовать материал в обход ответственного специалиста.
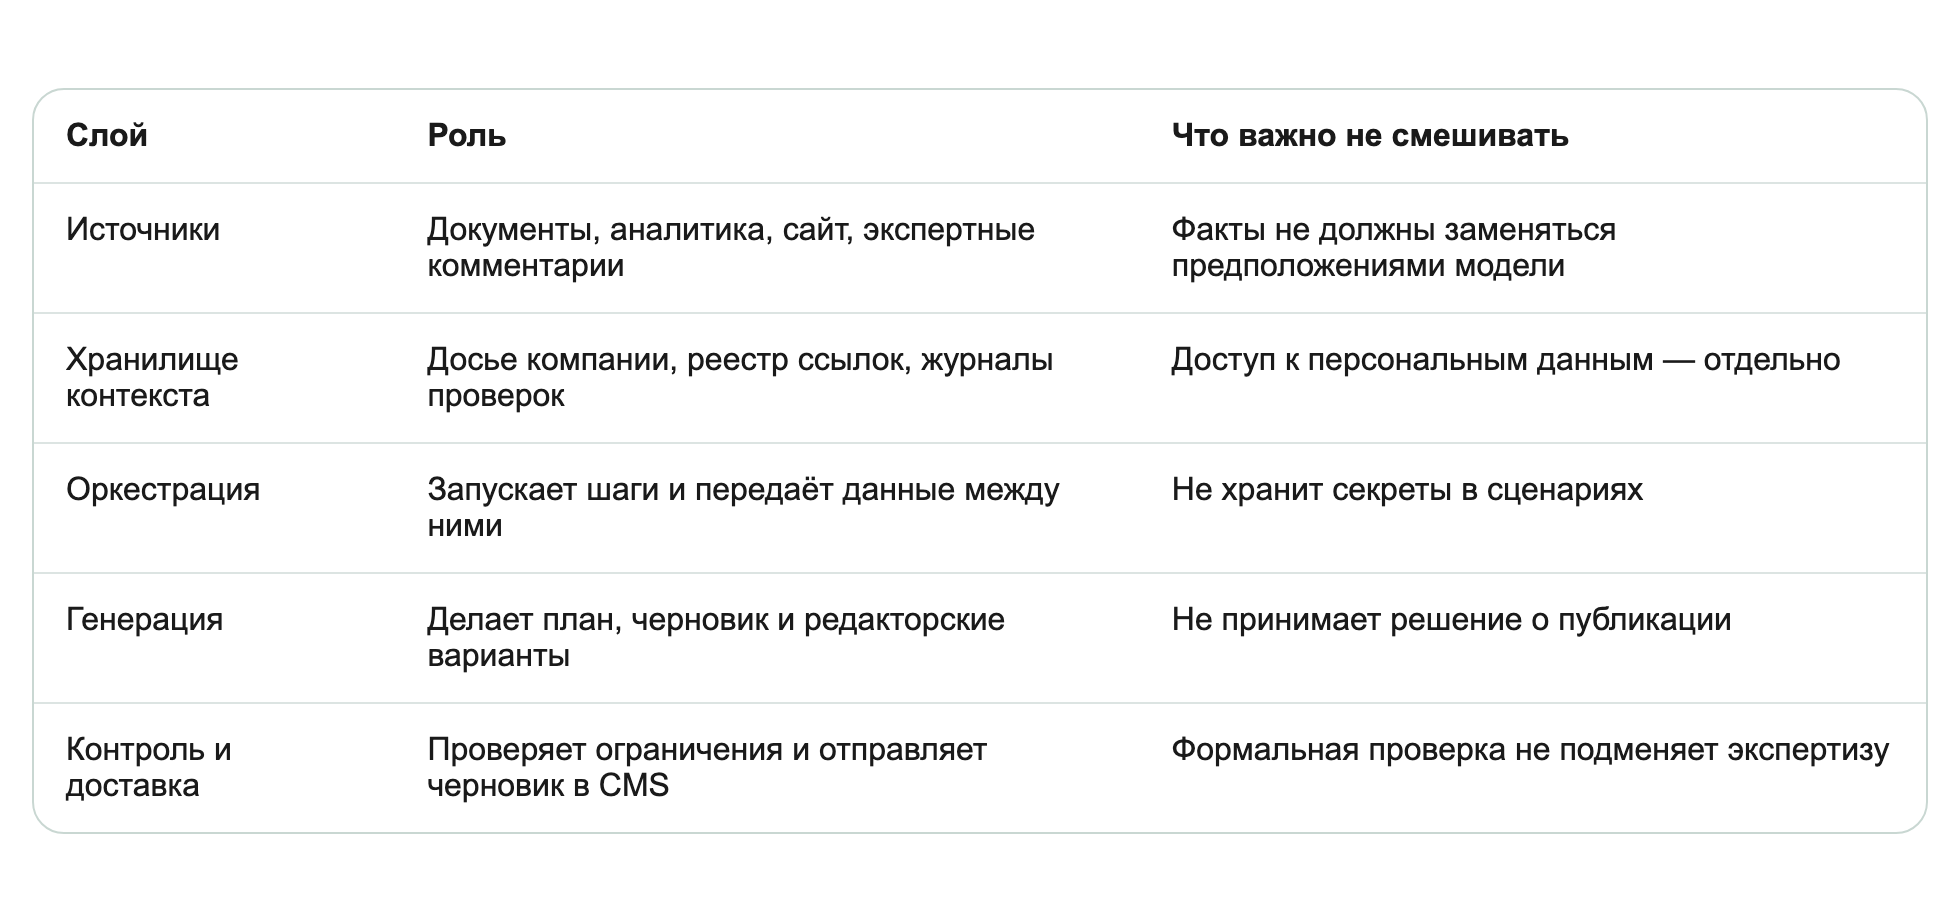
Архитектура: пять независимых слоёв
Показать данные текстом
| Слой | Роль | Что важно не смешивать |
| Источники | Документы, аналитика, сайт, экспертные комментарии | Факты не должны заменяться предположениями модели |
| Хранилище контекста | Досье компании, реестр ссылок, журналы проверок | Доступ к персональным данным — отдельно |
| Оркестрация | Запускает шаги и передаёт данные между ними | Не хранит секреты в сценариях |
| Генерация | Делает план, черновик и редакторские варианты | Не принимает решение о публикации |
| Контроль и доставка | Проверяет ограничения и отправляет черновик в CMS | Формальная проверка не подменяет экспертизу |
Показать картинку
Такое разделение помогает заменить модель, парсер или CMS без переписывания всей системы. Расчётные правила и журнал проверок остаются вашими.
Шаг 1. Начните с контура данных
Сначала определите, какие данные допустимо использовать на каждом шаге. Для аграрного контента обычно нужны:
- протоколы опытов, инструкции, регистрационные данные и утверждённые карточки продуктов;
- материалы отдела продаж, но только после редакционной проверки;
- данные веб-аналитики и панелей поисковых систем;
- инвентарь существующих URL для внутренней перелинковки;
- список тем, экспертов и владельцев страниц.
Не загружайте в генеративный сервис выгрузки из CRM, номера телефонов, адреса, неанонимизированные кейсы и другие персональные данные, если в этом нет необходимости и законного основания. Лучше отделить персональные данные от редакционного контура и подставлять согласованные атрибуты уже после подготовки черновика.
Структура проекта
На старте достаточно файлов с понятными именами. Их удобно проверять, версионировать и переносить между окружениями.
projects/{домен}/
├── context/
│   ├── company-profile.json       # подтверждённые сведения о компании
│   ├── source-register.json       # документы, версии и даты проверки
│   ├── experts.json               # роли проверяющих, без лишних персональных данных
│   └── links-inventory.json       # разрешённые URL и темы страниц
├── briefs/
│   └── {slug}.json                # задача, аудитория, источники, ограничения
├── drafts/
│   ├── {slug}-draft.md
│   └── {slug}-reviewed.md
├── audit/
│   └── {slug}.json                # результаты автоматических и ручных проверок
└── config/
    └── settings.example.json      # шаблон конфигурации без ключей
У каждой записи источника должны быть URL или внутренний идентификатор, дата проверки, версия и владелец. Это позволяет быстро найти все статьи, которые надо обновить после изменения регламента или продукта.
Пример инвентаря ссылок:
{
  "site": "example-agro.ru",
  "updated_at": "2026-08-15",
  "pages": [
    {
      "url": "/blog/kontent-zavod-apk/",
      "title": "Контент-завод для АПК",
      "topic": "процесс и экспертная проверка",
      "status": "published"
    }
  ]
}
Модель должна получать ссылки только из этого файла. Иначе она способна придумать правдоподобный, но несуществующий URL.
Шаг 2. Секреты и доступы
Ключи API, пароли приложений и подписывающие ключи не должны попадать в код, markdown-черновики, логи или репозиторий. Храните их в секрет-хранилище платформы либо в переменных окружения сервиса. В репозитории оставляйте только файл-пример с названиями переменных.
LLM_PROVIDER=
LLM_API_KEY=
WEBMASTER_OAUTH_TOKEN=
CMS_BASE_URL=
CMS_PUBLISH_TOKEN=
Для внешнего доступа используйте отдельные технические учётные записи с минимальными правами. У записи, которая создаёт черновики, не должно быть прав на публикацию, удаление материалов или управление пользователями CMS.
Шаг 3. Генеративный слой: один интерфейс для провайдеров
Выбирайте провайдера по договорным условиям, требованиям к данным, качеству русского языка, стоимости на реальном объёме и стабильности API. Конкретные модели, тарифы, лимиты и адреса методов быстро меняются, поэтому держите их в конфигурации, а не в логике конвейера.
Ни одна процедура не должна вызывать API провайдера напрямую. Введите небольшой адаптер:
from dataclasses import dataclass
from typing import Protocol

@dataclass
class GenerationRequest:
    system: str
    prompt: str
    max_output_tokens: int = 3000
    temperature: float = 0.2

class TextGenerator(Protocol):
    def generate(self, request: GenerationRequest) -> str: ...

def make_draft(generator: TextGenerator, brief: dict, facts: list[dict]) -> str:
    allowed_facts = "\n".join(
        f"- {x['text']} [источник: {x['source_id']}]" for x in facts
    )
    prompt = f"""Подготовь черновик по брифу: {brief['goal']}.
Аудитория: {brief['audience']}.
Используй только перечисленные факты. Если данных не хватает,
оставь пометку [НУЖЕН ИСТОЧНИК], не выдумывай информацию.

Факты:
{allowed_facts}
"""
    return generator.generate(GenerationRequest(
        system="Ты редактор отраслевого B2B-издания. Не давай непроверенных рекомендаций.",
        prompt=prompt,
    ))
Смена поставщика в таком случае затрагивает один адаптер. В него же стоит добавить ограничение расходов, повтор запросов с задержкой и журнал идентификаторов запросов — без записи содержимого чувствительных данных.
Шаг 4. Данные поисковых систем и анализ страниц
Панели поисковых систем и веб-аналитика помогают выбрать темы, найти технические ошибки и увидеть реальное поведение пользователей. Перед подключением каждого API отдельно проверьте актуальную схему авторизации и разрешения: даже сервисы одной экосистемы могут использовать разные типы ключей и области доступа.
Страницы из выдачи полезны для исследования намерения пользователя, формата ответа и обязательных вопросов. Их нельзя использовать как заготовки для рерайта. Автоматический сбор допускается только с учётом правил сайта, нагрузки на сервер, ограничений доступа и авторских прав.
Вместо «идеальной частоты фраз» фиксируйте в брифе:
- вопрос пользователя и его контекст: культура, регион, сезон, тип хозяйства;
- подзадачи, на которые требуется ответ;
- собственные данные и источники, способные сделать ответ полезнее конкурентов;
- важные ограничения, риски и случаи, когда нужна очная консультация;
- естественные термины, которые нельзя подменить расплывчатыми синонимами.
Это сохраняет техническую дисциплину, но не превращает текст в набор ключевых слов. Поисковые системы умеют понимать смысловые варианты запросов; искусственные квоты и массовые вариации страниц создают риск переоптимизации.
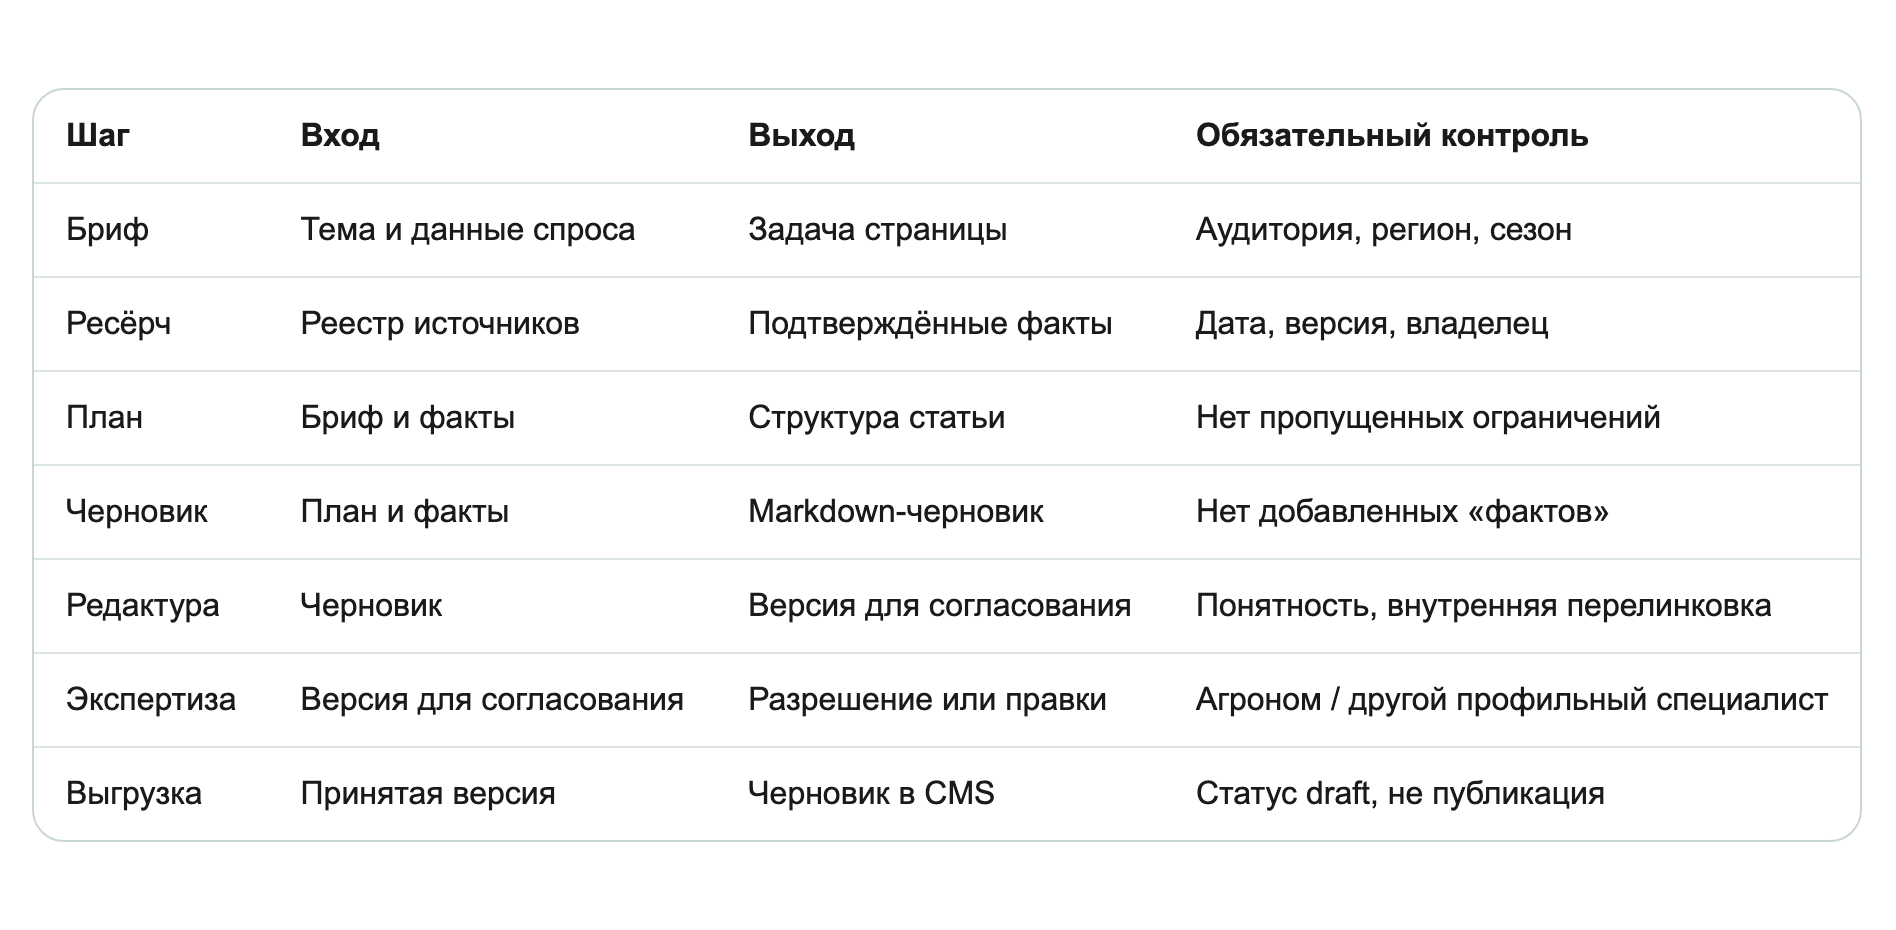
Шаг 5. Производственный сценарий
Разбейте работу на короткие и проверяемые шаги.
Показать данные текстом
| Шаг | Вход | Выход | Обязательный контроль |
| Бриф | Тема и данные спроса | Задача страницы | Аудитория, регион, сезон |
| Ресёрч | Реестр источников | Подтверждённые факты | Дата, версия, владелец |
| План | Бриф и факты | Структура статьи | Нет пропущенных ограничений |
| Черновик | План и факты | Markdown-черновик | Нет добавленных «фактов» |
| Редактура | Черновик | Версия для согласования | Понятность, внутренняя перелинковка |
| Экспертиза | Версия для согласования | Разрешение или правки | Агроном / другой профильный специалист |
| Выгрузка | Принятая версия | Черновик в CMS | Статус draft, не публикация |
Показать картинку
Автоматизация особенно полезна в четырёх местах: сборе структуры брифа, нормализации фактов, формальной проверке и выгрузке в черновики. Экспертная оценка норм, регламентов и выводов остаётся отдельным обязательным шагом.
Шаг 6. Приёмка кодом: что действительно можно проверить
Код хорошо проверяет формальные правила: есть ли незакрытые пометки для редактора, ведут ли ссылки на разрешённые страницы, не попали ли в текст служебные теги, проставлены ли дата проверки и автор. Он не проверяет истинность агрономического совета.
import re
from urllib.parse import urlparse

def audit_markdown(text: str, allowed_paths: set[str]) -> list[str]:
    issues = []
    if "[НУЖЕН ИСТОЧНИК]" in text:
        issues.append("В тексте остались утверждения без источника")
    if re.search(r"<[^>]{1,200}>", text):
        issues.append("В тексте есть служебная разметка")

    links = re.findall(r"\[[^]]+\]\(([^)]+)\)", text)
    for url in links:
        path = urlparse(url).path
        if path.startswith("/") and path not in allowed_paths:
            issues.append(f"Внутренняя ссылка не найдена в инвентаре: {path}")

    for field in ("Автор:", "Проверено экспертом:", "Дата проверки:"):
        if field not in text:
            issues.append(f"Не заполнено поле: {field}")
    return issues
Результат такой проверки должен быть REVIEW, пока эксперт не подтвердил материал. Статус PASS допустим только после объединения формального результата с ручным решением ответственного лица.
Шаг 7. Выгрузка в CMS
Отправляйте в CMS черновик, а не публикацию. Заголовок, описание, slug, изображение, дата проверки и автор должны передаваться как отдельные поля, а не извлекаться из тела текста регулярными выражениями.
Для WordPress можно использовать штатный REST API и пароль приложения по HTTPS. Ограничьте техническому пользователю набор разрешённых действий и проверяйте ответ сервера: статус записи должен остаться draft.
curl --fail-with-body -X POST "$CMS_BASE_URL/wp-json/wp/v2/posts" \
  --user "$CMS_USER:$CMS_APP_PASSWORD" \
  -H "Content-Type: application/json" \
  -d @payload.json
Для 1С-Битрикс безопаснее сделать узкий серверный обработчик: он принимает подписанный запрос, валидирует обязательные поля и создаёт неактивный элемент инфоблока. Не выдавайте внешнему сценарию универсальные административные права.
Перед выгрузкой проверьте:
- Все внутренние ссылки присутствуют в инвентаре URL.
- Все обязательные поля метаданных заполнены.
- В тексте нет служебных тегов, задач редактору и персональных данных, не согласованных для публикации.
- CMS вернула идентификатор черновика и не изменила статус на публикацию.
Шаг 8. Наблюдаемость и обновления
Логируйте не текст запросов и не секреты, а технические события: идентификатор задачи, время каждого этапа, статус проверки, версию шаблона, версию источника, расходы и идентификатор черновика в CMS. Так можно обнаружить сбой, не превращая журналы в хранилище чувствительных данных.
Минимальные сигналы для мониторинга:
- доля черновиков, возвращённых экспертом на существенную доработку;
- задержка от брифа до черновика и от проверки до публикации;
- ошибки API и повторные попытки;
- изменение стоимости и лимитов;
- процент страниц с устаревшей датой проверки;
- показы, переходы и целевые действия после публикации.
Не останавливайте процессы браузера или очереди широкими командами «на всякий случай». Лучше задайте лимит времени отдельной задаче, ведите её идентификатор и завершайте только этот процесс после понятного тайм-аута.
Шаг 9. Инфраструктура и персональные данные
Конфигурация сервера зависит от числа одновременных задач, размера документов, использования браузерного рендеринга и хранения файлов. Начните с небольшого изолированного окружения, измерьте фактическую нагрузку и масштабируйте по данным, а не по усреднённой конфигурации из статьи.
Если в контуре есть персональные данные граждан РФ, заранее определите оператора, состав обрабатываемых данных, места их первичного сбора и хранения, основания обработки, доступы и порядок трансграничной передачи. Требования к локализации и уведомлению регулятора зависят от конкретного процесса; это нужно проверить с юристом и специалистом по защите данных до запуска.
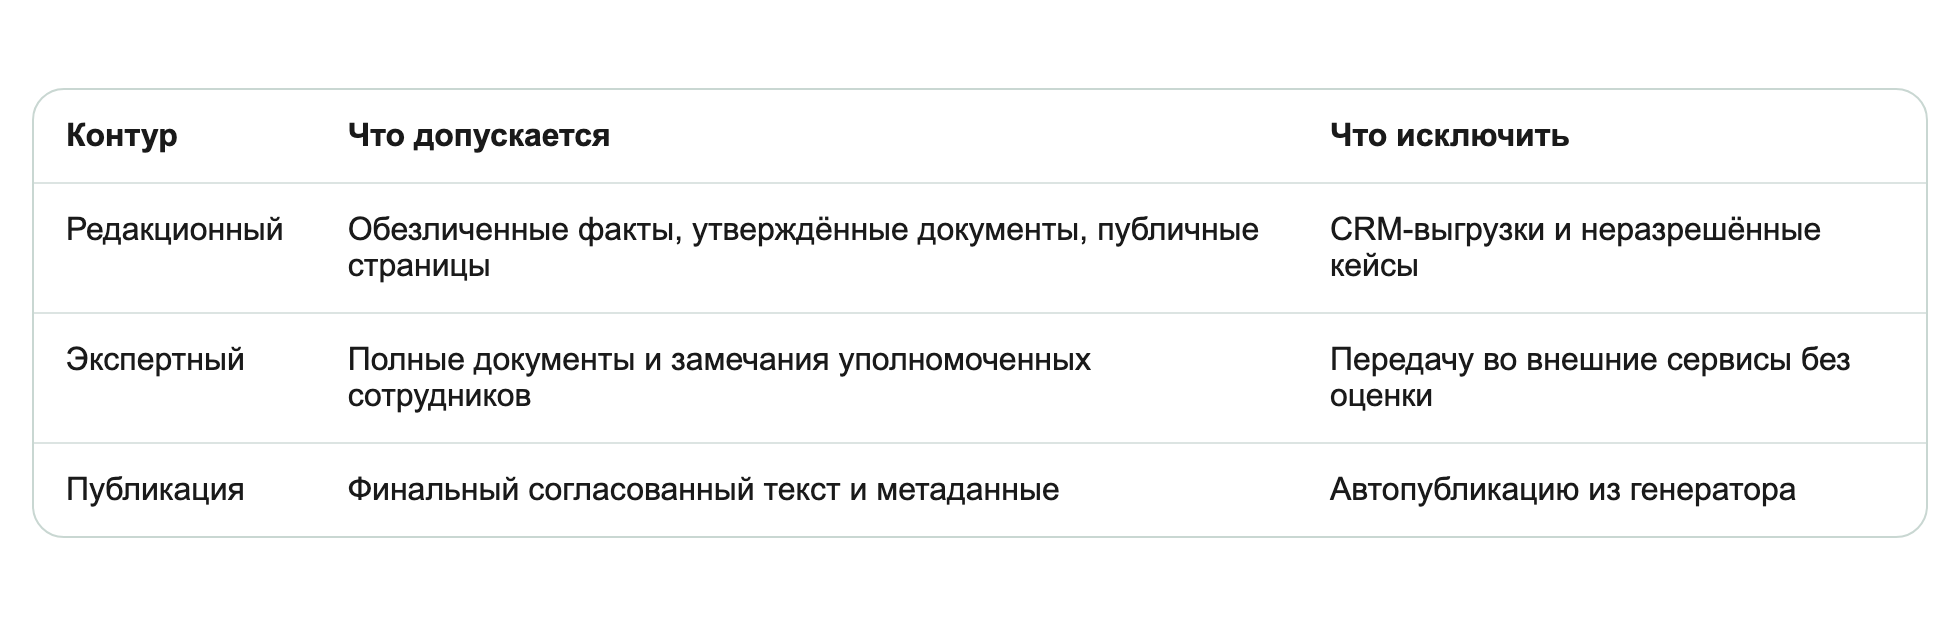
Для контент-завода обычно безопаснее следующее разделение:
Показать данные текстом
| Контур | Что допускается | Что исключить |
| Редакционный | Обезличенные факты, утверждённые документы, публичные страницы | CRM-выгрузки и неразрешённые кейсы |
| Экспертный | Полные документы и замечания уполномоченных сотрудников | Передачу во внешние сервисы без оценки |
| Публикация | Финальный согласованный текст и метаданные | Автопубликацию из генератора |
Показать картинку
Шаг 10. Как пережить смену стека
Интеграции и тарифы меняются. Чтобы не переделывать конвейер при каждой смене сервиса, соблюдайте четыре правила:
- Держите провайдера модели за интерфейсом, а не в каждом скрипте.
- Храните модели, лимиты, URL и пороги в конфигурации.
- Фиксируйте версии библиотек и проверяйте интеграции на тестовом проекте после обновлений.
- Делайте шаги идемпотентными: повторный запуск не должен создавать дубликаты в CMS или повторно списывать деньги без необходимости.
Перед выпуском системы проверьте официальную документацию каждого подключаемого API: маршруты, схема авторизации, лимиты, стоимость и правила работы меняются быстрее, чем методические статьи.
Итоговый чек-лист запуска
- Есть досье компании и реестр проверенных источников.
- У каждого факта есть источник, дата проверки и владелец.
- Секреты изолированы, технические учётные записи имеют минимальные права.
- Генератор заменяем, а правила приёмки и журнал проверок принадлежат компании.
- Автопроверка ищет незаполненные источники, служебную разметку и недопустимые ссылки.
- Эксперт подтверждает текст до выгрузки.
- CMS получает только черновики.
- У опубликованной страницы есть автор, дата проверки и владелец обновления.
Такой контент-завод не обещает «идеальный текст за минуту». Он делает важное: сокращает рутину, оставляет след каждого решения и не позволяет автоматизации выдать непроверенную информацию за экспертный материал.
 12 мин
 27 мая 2026