Агрокаталог нельзя просто перенести

Семена, запчасти, средства защиты: почему при переносе ломается не вёрстка, а модель данных
Представим типичную приёмку. Сайт переехал на новую платформу, дизайн заметно лучше прежнего, страницы открываются быстро, каталог на месте — все четыреста позиций. Приёмка пройдена.
Потом выясняется, что клиент хочет подобрать гибрид кукурузы с ФАО от 200 до 250, а на сайте это сделать нечем. Значение ФАО в карточке есть — оно видно в тексте описания вместе с остальными характеристиками. Но лежит там строкой. Диапазонного фильтра по нему нет, и группы спелости в фильтрах тоже нет, хотя она из ФАО и выводится.
Чтобы фильтр появился, придётся выделить ФАО в отдельное структурированное поле. Часть значений извлекается из описаний скриптом, но результат нужно проверить по всем четырёмстам карточкам: в текстах встречаются диапазоны, опечатки и позиции, где показателя нет вовсе.
Такая ситуация возникает, когда требования к отбору позиций не сформулированы на старте. Фильтры и сравнение видны на сайте не хуже дизайна — но проверить их можно только тогда, когда заранее известно, по каким характеристикам покупатель будет искать. Если этого нет в задании, нет и в приёмке.
Агрокаталог устроен сложнее, чем кажется
Разница между каталогом одежды и каталогом средств защиты растений не в количестве позиций. Она в том, как характеристики связаны между собой.
В одежде размер и цвет — оси вариантов: одна модель существует в нескольких сочетаниях, у каждого свой артикул, своя цена и свой остаток. Задача известная, и типовые платформы электронной коммерции обычно её покрывают.
Инструменты для сложных характеристик тоже существуют: системы управления товарными данными и гибкие движки умеют пользовательские атрибуты, справочники и связи между сущностями. Готовым из коробки не бывает другое — агрономическая семантика. Что именно считать характеристикой, какого она типа, как связана с остальными и откуда обновляется, приходится проектировать под конкретный каталог.
Разберём три типичных случая.
Семена и гибриды

ФАО — числовой индекс, обычно от 100 до 999. По нему покупатель ищет диапазоном: «от 200 до 250».
Группа спелости — категория, которая соотносится с диапазоном ФАО. Универсальной таблицы соответствий нет: и названия групп, и их границы различаются между источниками и производителями — где-то выделяют очень ранние и ранние по отдельности, где-то объединяют. Для модели данных это ключевое обстоятельство. Устойчивое решение — хранить не одно значение, а несколько: исходное ФАО, группу в том виде, как её указал производитель, вычисленную по собственной таблице соответствий нормализованную группу и версию самой таблицы. Тогда расхождения видны и объяснимы, а в фильтре используется нормализованное значение.
Если оставить только одно поле, исходные данные теряются, и через год никто не сможет сказать, почему у двух гибридов с близким ФАО разные группы.
Устойчивость к болезням — набор значений: у одного гибрида их пять, у другого один. Здесь же вопрос шкалы: «устойчив» и «толерантен» — не одно и то же, а балльная оценка требует указания методики. Без этого характеристика останется неоднозначной, даже если аккуратно занесена в справочник.
Рекомендованные регионы возделывания и регионы доставки — два разных отношения, даже если оба опираются на один справочник субъектов. Первое говорит об агрономической пригодности, второе о логистике. Ошибка здесь не в том, что их значения могут не совпадать, а в попытке хранить их одним полем: тогда либо покупатель увидит гибрид, который ему не привезут, либо каталог скроет позицию, пригодную для его зоны.
Норма высева зависит от зоны и срока сева. Это не одно число в карточке, а зависимость.
Пять характеристик, и ни одна не устроена так же, как соседняя: число для диапазона, вычисляемая категория, многозначный справочник со шкалой, две разные привязки к географии, зависимость от условий.
Запчасти к технике

Главная сложность одна, но она перевешивает остальные: применимость.
Одна деталь подходит к нескольким моделям. У одной модели — тысячи деталей. Это связь многие-ко-многим, и текстовое поле «подходит для…» упирается в потолок при первом же запросе «покажите всё, что подходит к моей машине».
Но и справочника моделей мало. На практике применимость зависит от модификации, года выпуска, установленного двигателя, иногда — от диапазона серийных номеров и комплектации. Каталог, который знает только модель, будет уверенно выдавать деталь, не подходящую конкретной машине. Это хуже, чем отсутствие фильтра: покупатель получил ответ, поверил ему и заказал не то.
Сверх того — аналоги и заменители, то есть связь позиции с другой позицией того же каталога. И разделение на оригинал и неоригинал, которое влияет и на цену, и на фильтр, и на подачу в карточке.
Мы ведём несколько сайтов в веб-контуре Ростсельмаша и хорошо представляем, во что превращается каталог, когда номенклатура техники и номенклатура деталей должны быть связаны корректно.
Средства защиты растений
Здесь модель данных отличается принципиально, и именно её чаще всего упрощают.
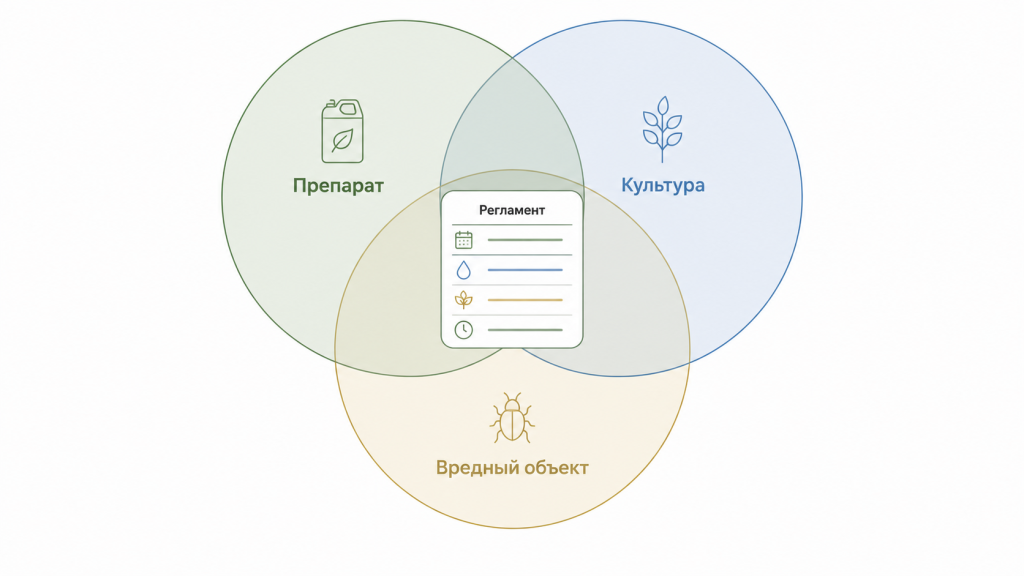
Регламент применения — не свойство препарата. Это самостоятельная запись со своим идентификатором, связанная с препаратом, культурой и вредным объектом. У неё собственные поля: в том числе норма расхода, способ и время обработки, особенности применения, срок ожидания, кратность обработок, а также сроки безопасного выхода людей на обработанные площади для ручных и механизированных работ.
Важно, что сочетание «препарат — культура — вредный объект» задаёт связи, но не гарантирует единственности записи: для одного и того же сочетания могут существовать разные строки применения с разными нормами, способами обработки или условиями. Модель, где регламент считается свойством карточки препарата, эту множественность теряет.
И ключевой момент, который ломает наивную схему: один и тот же препарат может быть разрешён против вредного объекта на одной культуре и не разрешён против того же объекта на другой. Если регламенты хранятся как «список культур» в карточке, разница исчезает — и сайт начинает показывать применение, которого в регламенте нет.
Отсюда требования, которых не бывает в обычной электронной коммерции.
С 1 сентября 2025 года общее условие обращения пестицидов и агрохимикатов в России — государственная регистрация в Реестре пестицидов и агрохимикатов. Это установлено Федеральным законом № 534-ФЗ от 28.12.2024. Закон предусматривает отдельные исключения, а свидетельства о государственной регистрации, выданные до этой даты, действуют до окончания своего срока. Порядок ведения Реестра утверждён приказом Минсельхоза России от 16.05.2025 № 342, вступившим в силу с той же даты.
Для каталога это означает, что у регистрационного статуса и регламентов есть определённый авторитетный источник — Реестр. Остальные данные поступают из разных источников: ассортимент, цены и остатки — из учётной системы, описания и изображения — от производителя, сведения об упаковке — из регистрационной документации. Разные части карточки живут по разным правилам, и у каждого блока стоит определить своего владельца — того, кто отвечает за его актуальность.
Для регулируемой части в модели должны появиться: номер государственной регистрации, ссылка на источник, дата вступления изменений в силу, статус записи, версия и понятная процедура, кто и как публикует обновления. Без этого каталог со временем начинает молча расходиться с Реестром.
Ошибка здесь опаснее неудобного фильтра: сайт публикует информацию о применении, расходящуюся с зарегистрированным регламентом. Для компании это репутационный и потенциальный юридический риск, для хозяйства, которое руководствовалось информацией сайта, — агрономический.
Решения, которые определяют судьбу проекта
Судьба каталога решается не при выборе платформы и не на вёрстке. Она решается, когда кто-то отвечает на несколько вопросов, и ответы живут потом годами.
Какого типа характеристика
Самое частое упрощение — считать, что выбор стоит между «текстом» и «справочником». На деле типов больше, и каждый даёт свой способ поиска.
Число с единицей измерения — фильтр диапазоном. Категория — фильтр выбором. Многозначный справочник — фильтр по нескольким значениям сразу. Булево значение — галочка. Иерархия — дерево. Зависимость от условий — таблица, а не поле. Связь с другой сущностью — отдельный подбор.
Записать характеристику свободным текстом можно всегда, и выглядеть в карточке она будет прилично. Отбирать по ней позиции тоже возможно: полнотекстовый поиск, словари синонимов, извлечение значений из текста при импорте — всё это существует и работает.
Разница не в возможности, а в цене и предсказуемости. Текст живёт разнобоем формулировок, извлечение ошибается на краевых случаях, поддержка словарей ложится на кого-то надолго, а результат отбора трудно гарантировать.
Структурированные характеристики тоже требуют сопровождения — справочники пополняются, появляются синонимы, единицы приходится пересчитывать, источники конфликтуют между собой. Но эта работа обычно более предсказуема и контролируема, чем разбор накопившегося текста.
Проверить решение подрядчика можно просто: попросите показать, по каким характеристикам будет устроен отбор и какого типа каждая. Если в ответ звучит только «сделаем поиск по каталогу» — уточните, сознательный ли это выбор. Иногда для небольшого каталога поиск действительно достаточен, но об этом стоит договориться явно, а не обнаружить постфактум.
Свойство или отдельная сущность
Применимость запчасти, регламент применения, зависимость нормы высева от зоны — плохо ложатся в карточку как поля.
Технически поместить в карточку можно почти всё: составное поле или структура в формате JSON вместит любую сложность.
Дальше начинается вопрос цены. Без отдельной схемы и дополнительного инструментария такое поле в типовой CMS усложняет проверку корректности данных, контроль ссылок на справочники, версионирование отдельных записей и удобное редактирование. Всё это реализуемо — схемой валидации, хранением идентификаторов, собственной формой для контент-менеджера. Но тогда JSON перестаёт быть дешёвым способом обойтись без проектирования модели: вы всё равно проектируете, только неявно и без поддержки платформы.
Регламент при этом живёт своей жизнью — он меняется, когда меняется Реестр, а не когда правят описание препарата.
Признак, по которому отличить: если характеристика описывается сочетанием нескольких условий («для этой культуры против этого объекта такая норма»), а таких сочетаний много и они меняются отдельно от товара — это отдельная сущность.
Переделка здесь затрагивает не описания, а связи между тысячами позиций, и часто обходится дороже, чем смена типа характеристики.
Как соотносятся близкие категории
Сорт и гибрид для агронома — разные вещи. В системе это может быть общая базовая сущность с двумя подтипами и разными наборами характеристик, а может — два отдельных каталога.
Универсального правильного ответа нет; выбор зависит от того, насколько различаются характеристики, как компания продаёт и что нужно выводить в общих списках. Есть только требование, чтобы ответ дал человек, понимающий предмет, а не тот, кто переносит данные с одного сайта на другой.
Что здесь может машина, а что требует человека
Мы используем ИИ-агентов при переносе сайтов и видим границу довольно отчётливо.
Механическую часть агент делает хорошо и быстро. Он разбирает старый сайт, находит повторяющиеся блоки и считает, на скольких страницах встречается каждый. Выписывает состав карточки: заголовок, изображение, характеристики, кнопка. Собирает заготовку технического задания со списком характеристик и ссылками на конкретные места в разметке.
Отдельно полезно, что он сводит разнобой. Формулировки «засухоустойчивый», «устойчив к засухе» и «толерантность к засухе» на старом сайте живут как три разных текста. Агент собирает их в список кандидатов на один элемент справочника. Это не окончательный ответ — краевые случаи и спорные значения проверяет человек, — но ручной работы становится существенно меньше.
Агент способен и на большее. Получив нужные документы и правила, он предложит связь многие-ко-многим там, где видит перечисление, отметит регулируемые поля, сформулирует вариант модели данных.
На практике остаются три ограничения.
Первое — полнота предоставленного контекста. Агент видит старый сайт и то, что ему дали. Какой раздел приносит компании половину заявок, какие характеристики покупатели спрашивают у менеджеров, что планируется добавить в ассортимент через год — всё это он учтёт, если получит доступ к аналитике, CRM и внутренним документам. Но по умолчанию этих данных у него нет, а модель строится в том числе из них.
Второе — проверяемость результата. Даже правдоподобная модель может содержать краевой случай, который обнаружится при пилотном наполнении или позже, уже в эксплуатации. Поэтому модель проверяют на репрезентативной выборке реальных данных до того, как по ней начнут работать.
Третье, и главное, — ответственность. Решение о модели данных живёт годами и дорого в переделке. За него отвечает человек, который его принял.
Формулировка получается такая: анализ и подготовку модели автоматизировать можно и нужно, а решение остаётся за специалистом, понимающим предмет.
Что теряется при неверной модели
Последствия проявляются не сразу и по отдельности выглядят мелкими.
Надёжный отбор по характеристикам становится сложнее и дороже. Формально фильтровать по извлечённым из текста значениям можно, но результат приходится всё время проверять и подправлять словари, а покупатель видит выдачу, за полноту которой никто не отвечает.
Автоматическое сравнение позиций требует предварительного извлечения и нормализации значений — то есть той же работы, которую стоило формализовать на этапе проектирования, а затем вести как контролируемый процесс.
Усложняется обмен данными. При выгрузке в 1С, на маркетплейсы или в CRM выяснится, что у характеристик нет структуры, а значит нет и соответствия полям принимающей системы. Задача решаемая — через промежуточную схему и повторно используемые правила преобразования, — но это отдельная работа, которой могло не быть. Стоит помнить и обратное: часто именно 1С является источником каталога, и тогда структура должна согласовываться с ней с самого начала.
Сложнее становится и с поисковым трафиком. Запросы вида «гибрид кукурузы ФАО 250» или «фильтр масляный для комбайна» — с понятным намерением, и страницы под них строятся из структурированных характеристик. Но структура сама по себе трафика не даёт.
Фасетная навигация — известный источник проблем с обходом сайта. Комбинации фильтров порождают практически бесконечное количество адресов, и в рекомендациях Google по обходу таких страниц прямо названы два последствия: избыточный обход бесполезных адресов и, как следствие, замедленное обнаружение новых полезных страниц.
Там же указано, что канонические адреса и атрибут rel="nofollow" в долгосрочной перспективе менее эффективны, чем прямой запрет обхода — через robots.txt или перенос фильтров во фрагмент адреса.
Рабочее решение состоит из нескольких частей: решить, какие комбинации фильтров вообще должны быть доступны поисковику; сделать отдельные посадочные страницы под проверенный спрос, с собственным содержанием; закрыть остальное от обхода. И отдельно — отдавать код 404 по адресу, где комбинация фильтров не дала результатов, а не редиректить на общую страницу ошибки.
И общее: переделка модели данных на наполненном каталоге обычно обходится дороже, чем проектирование на старте. При этом проектирование — не абзац в техническом задании. Это словарь характеристик с типами и единицами измерения, описание связей и их кардинальности, указание источников и правил обновления, схема переноса и приёмочные сценарии. Работа заметная, но основную модель проектируют до переноса данных, а дальше развивают по контролируемым правилам. Это обычно дешевле, чем сначала перенести неструктурированный каталог, а потом разбирать накопившиеся карточки.
Что спросить у подрядчика до начала работ
Эти вопросы помогают проверить понимание задачи до начала работ.
По каким характеристикам покупатель будет отбирать позиции и какого типа каждая? Хороший ответ — перечень с указанием типа: число, категория, многозначный справочник, связь.
Что описывается сочетанием условий, а не одним значением? Регламенты, применимость, зависимость нормы от зоны. Хороший ответ описывает отдельные сущности со своим жизненным циклом.
Откуда каталог обновляется и кто владелец каждого поля? Если данные приходят из 1С, а менеджер правит описания на сайте, нужно заранее договориться, какие поля перезаписываются при обмене, а какие нет.
По какому ключу позиции сопоставляются при обновлении? Правильный ответ — внутренний стабильный идентификатор плюс связка «источник данных и его внешний код». Артикул сам по себе ненадёжен: он меняется, повторяется у разных поставщиков и не всегда уникален. Сопоставление по названию создаёт высокий риск дублей и ошибочного сопоставления: что именно произойдёт при переименовании — появится дубль, создастся новая позиция или потеряется связь — зависит от механизма импорта.
Как проверяется полнота переноса? Сверки количества карточек мало — статья ровно о том, что суть каталога в связях. Правила приёмки должны включать: количество перенесённых связей, поиск записей без связанного товара, модели, культуры или вредного объекта, проверку ссылочной целостности, полноту многозначных связей и выборочную сверку старой и новой систем вручную. Плюс обычное: обязательность полей, единицы измерения, обработка пропусков и дублей.
Как ведутся регулируемые данные? Для средств защиты — номер государственной регистрации, ссылка на Реестр, дата вступления изменений в силу, версия записи и порядок обновления.
Что произойдёт, когда добавится новая характеристика? Хороший ответ описывает, что именно затрагивается: импорт, форма в административной части, карточка, фильтр, поисковый индекс, выгрузки. Ответ «добавим за час» сам по себе не плох — в гибкой схеме хранения новое свойство действительно заводится быстро. Уточните, что входит в этот час: только создание поля или также импорт, интерфейс, фильтр, выгрузки и проверка результата.
Что произойдёт, если перенос пойдёт не так? Должен быть тестовый прогон и сценарий отката.
Что из этого следует
Правку отдельного блока вёрстки обычно сделать проще, чем изменить структуру наполненного каталога: она локальна и не затрагивает данные. Крупные изменения дизайн-системы или адаптивных шаблонов — тоже проект, но результат непосредственно виден в интерфейсе.
Модель данных заметна гораздо меньше. На макете её нет, при беглой приёмке она выглядит нормально. Проявляется позже — когда понадобился фильтр, обмен с учётной системой или посадочные страницы. Увидеть её заранее можно: в словаре характеристик, в прототипе фильтра, в сценариях приёмки. Но для этого нужно смотреть именно туда.
В агробизнесе к этому добавляется сезон. Каталог семян должен работать к моменту, когда клиенты планируют сев. Переделка структуры в разгар продаж технически возможна — через параллельную схему, фоновое заполнение и переключение после проверки, — но это отдельный проект со своим бюджетом и рисками, и обычно его стараются не начинать в пик спроса.
Поэтому решения о модели данных стоит принимать на старте, а не тогда, когда выяснится, что фильтр не строится.
 10 мин
 6 мая 2026 в 05:41